Antes de escribir cualquier artículo, dedicaba entre 30 y 60 minutos a revisar manualmente Google Search Console. Abría la consola, filtraba por queries con impresiones pero CTR bajo, intentaba recordar si ya había cubierto ese tema, abría GA4 en otra pestaña para ver si ese tráfico tenía rebote alto o no… y después de todo ese proceso, muchas veces la decisión de qué escribir dependía más de la energía que tenía ese día que de lo que los datos decían realmente.
El problema no es solo el tiempo. Es la inconsistencia. Algunos días hacía ese análisis; otros, no. Y cuando no lo hacía, escribía lo que me parecía interesante en el momento. Con suerte coincidía con lo que la audiencia buscaba. No siempre.
Este artículo documenta el pipeline SEO automatizado que he construido sobre Google Cloud Platform para resolver exactamente ese problema. No voy a entrar en cómo está implementado técnicamente — eso es irrelevante aquí. Lo que me interesa explicar es qué problema resuelve, cómo funciona a nivel conceptual, y qué cambia en el workflow real cuando tienes un sistema que analiza tus datos de búsqueda cada mañana mientras duermes.
Un pipeline que trabaja mientras duermes
El sistema tiene dos componentes: un cron diario que corre a las 7:00 cada mañana y un dashboard de control que me muestra los resultados y me permite actuar sobre ellos sin salir de una sola pantalla.
La premisa es simple: cada mañana, antes de que yo abra el ordenador, el sistema ya ha analizado qué está buscando mi audiencia, ha cruzado eso con lo que ya tengo publicado, y ha identificado las oportunidades de contenido con mayor potencial estratégico. Cuando me siento a trabajar, no empiezo desde cero, empiezo desde datos.
Para un CMO, un fundador o cualquier persona que tome decisiones de contenido, la propuesta de valor es esta: el tiempo que antes dedicabas a entender qué escribir lo puedes dedicar ahora a escribirlo bien. El análisis ya está hecho.
Cómo funciona: de los datos de búsqueda a las oportunidades editoriales
Cada mañana el pipeline ejecuta cuatro pasos:
- Paso 1 — Extracción de datos reales. El sistema consulta Google Search Console y obtiene las queries de las últimas cuatro semanas: cuántas impresiones tiene cada una, en qué posición media aparece, cuál es el CTR, y qué URL del site está sirviendo esa query. Después cruza esos datos con Google Analytics 4: sesiones reales, bounce rate, tiempo en página. No son proyecciones ni estimaciones de herramientas de terceros, son los datos exactos de lo que está pasando en el site.
- Paso 2 — Contexto del site. El pipeline también extrae el catálogo de artículos publicados en WordPress: títulos, categorías, fechas, slugs. Esto es clave porque le da a Gemini el contexto de lo que ya existe, lo que permite identificar gaps reales en vez de sugerir artículos sobre temas que ya tengo cubiertos.
- Paso 3 — Análisis con Gemini. Todo ese contexto — queries, métricas, artículos publicados — se envía a Gemini con una instrucción editorial clara: identifica las 2-3 oportunidades de contenido más estratégicas, explica por qué cada una tiene potencial, sugiere un ángulo concreto, y proporciona las queries objetivo y los artículos existentes con los que enlazar.
- Paso 4 — Guardado de resultados. Las oportunidades se guardan en Google Cloud Storage, listas para ser consultadas desde el dashboard. Si ese día no abro el dashboard, los datos siguen ahí para el día siguiente.
Lo que hace especial este proceso no es la automatización por sí misma — es lo que Gemini aporta al análisis. Cada oportunidad incluye un campo que internamente llamo uniqueness_rationale: la justificación de por qué ese artículo concreto, con ese ángulo concreto, tiene sentido dado el perfil actual del site y las queries reales que están llegando. No es una lista de keywords con volumen, es razonamiento editorial fundamentado en datos.
El dashboard: tres pestañas que reemplazan tres flujos de trabajo
El dashboard es un panel Streamlit con tres pestañas. Cada una resuelve un problema diferente del flujo de trabajo SEO.
Tab 1 — Oportunidades: el briefing editorial del día
La primera pestaña muestra las oportunidades identificadas en el último análisis. Cada card incluye toda la información necesaria para tomar una decisión editorial: título propuesto, categoría recomendada, justificación estratégica, queries objetivo, links internos sugeridos con detección automática de artículos existentes relevantes, y una preview en tiempo real del meta SEO con contador de caracteres.
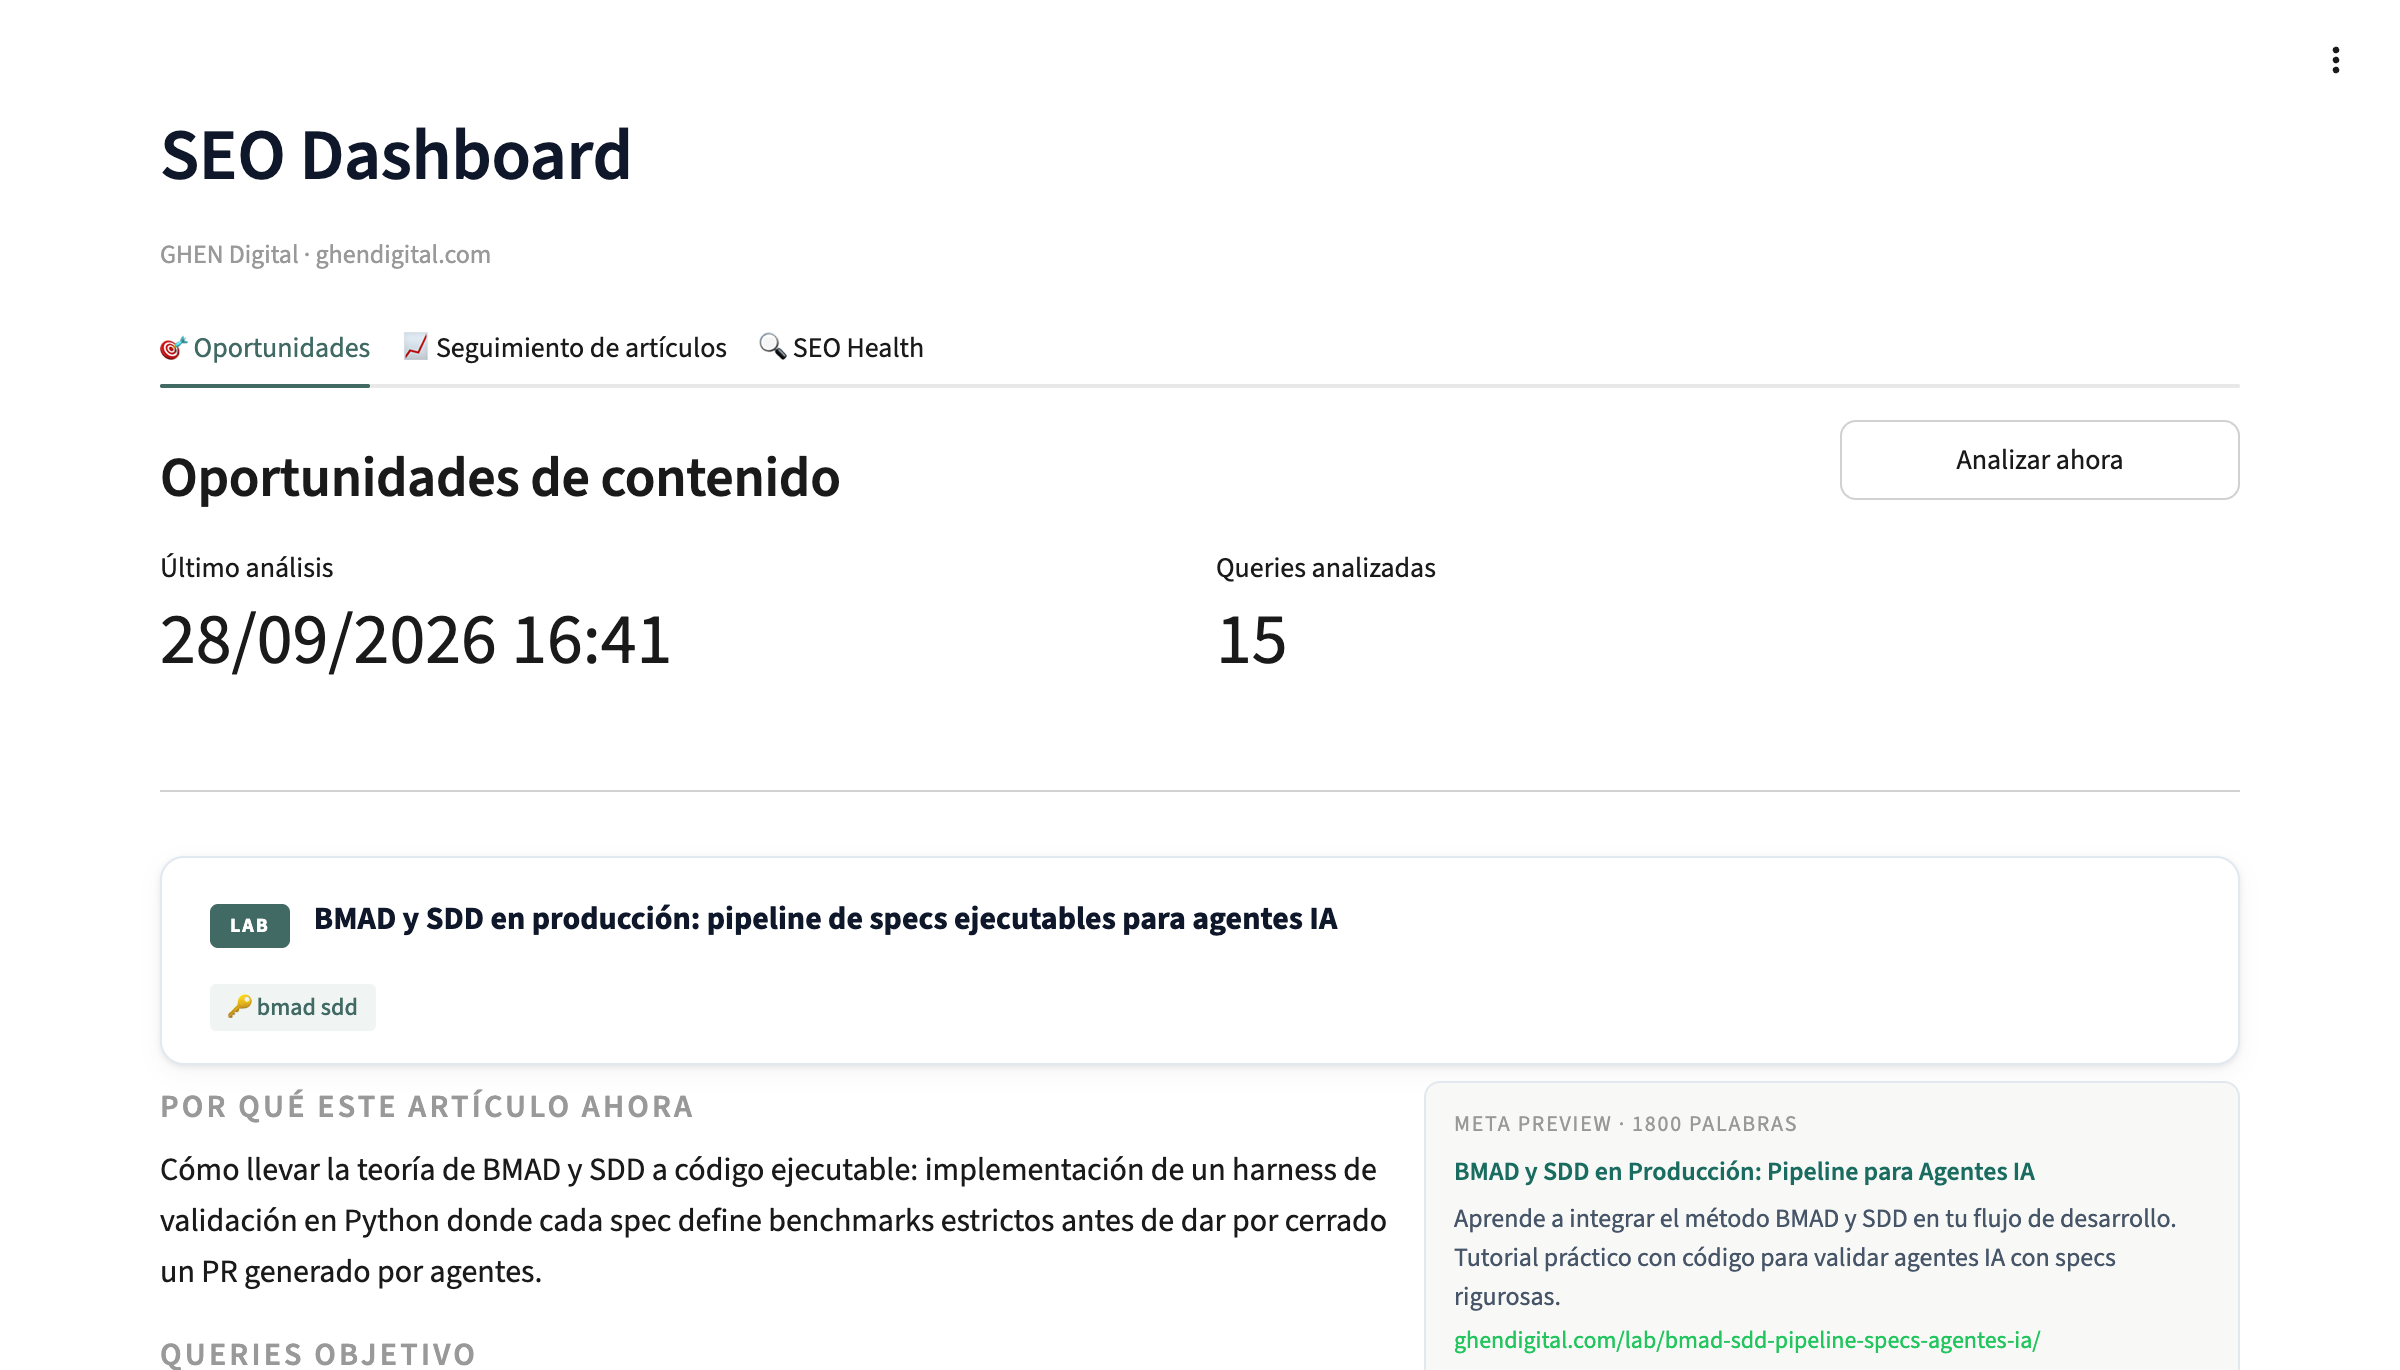
Desde esta pestaña puedo lanzar la generación del artículo con un clic, o descartar la oportunidad si no encaja con la agenda editorial del momento.
Lo que antes era un proceso de análisis manual de 30-60 minutos se convierte en una revisión de 5 minutos: las tarjetas ya traen el razonamiento hecho, yo solo tengo que decidir si estoy de acuerdo o no.
Hay un matiz importante aquí que quiero subrayar: el sistema sugiere, yo decido. Gemini puede identificar que hay una query con alta demanda que el site no cubre, pero si yo sé que ese tema no es relevante para mi audiencia o que ya tengo algo en borrador sobre eso, lo descarto. La autonomía editorial sigue siendo mía; lo que el sistema elimina es el trabajo de descubrimiento y, si aplica, de redacción.
Tab 2 — Seguimiento: conectar artículos publicados con rendimiento real
La segunda pestaña resuelve un problema diferente: saber cómo está rindiendo lo que ya he publicado. Pulso “Cargar / Actualizar” y en segundos tengo una tabla que cruza todos los posts de WordPress con sus datos de Google Search Console: posición media, impresiones, clics, CTR, y si el artículo está indexado o no.
El valor no es solo la conveniencia de tenerlo en un solo sitio, es la continuidad del análisis. El pipeline no solo identifica qué escribir: también muestra si lo que se escribió está funcionando, si hay artículos que llevan meses sin indexarse, o si hay piezas antiguas que están subiendo posiciones y merecerían un update.
Sin este panel, ese seguimiento requería abrir GSC, filtrar por URL manualmente, abrir WP Admin para comparar con las fechas de publicación, anotar los datos en algún sitio… fácilmente 20-30 minutos por revisión, y una revisión que en la práctica acaba siendo mensual en vez de semanal simplemente porque el proceso es tedioso.
Tab 3 — SEO Health: auditar y editar meta de Rank Math sin abrir WP Admin
La tercera pestaña es la que más tiempo me ahorra en tareas de mantenimiento. Introduzco un Post ID de WordPress y pulso “Cargar post”. Al instante veo el título SEO, la meta description y el focus keyword configurados en Rank Math, con contadores de caracteres y una valoración del estado SEO de esos campos.
Puedo editar esos campos directamente desde el dashboard y guardar los cambios con un clic. Sin abrir WordPress. Sin navegar por el editor de bloques. Sin perder el contexto de lo que estaba analizando.
Si alguna vez has tenido que revisar y actualizar los meta de 50 o 100 artículos — porque migraste de plugin SEO, porque tu estrategia de titulación cambió, porque descubriste que muchos posts tienen descriptions cortadas — sabes lo que supone hacer eso en WP Admin. Esta pestaña convierte ese trabajo de medio día en una sesión de trabajo normal.
Qué cambia en el workflow real y qué sigue necesitando intervención humana
Después de varias semanas usando este sistema, el cambio más visible no es cuantitativo todavía (las posiciones tardan meses en moverse, prometo compartir resultados en 3, 4 meses) sino cualitativo. Las decisiones de contenido han dejado de depender de la disponibilidad y el estado mental del momento para basarse en datos concretos y razonamiento estructurado que ya está preparado cuando lo necesito.
El ahorro de tiempo estimado está en torno a las 3-4 horas semanales que antes dedicaba a análisis manual disperso. Pero lo que más valoro es la consistencia: el pipeline analiza los datos cada mañana independientemente de si tengo tiempo o no. El lunes tengo las oportunidades del fin de semana esperándome. Si publico un artículo el martes, el jueves ya tengo datos de primeras impresiones.
Lo que sigue necesitando intervención humana, y en mi opinión debe seguir necesitándola: el juicio editorial sobre qué oportunidad priorizar dado el contexto del negocio, la revisión de escritura del artículo con experiencia y perspectiva propia, la revisión de calidad antes de publicar, y la interpretación de tendencias que los datos solos no capturan.
Si tienes un blog con cierto volumen de contenido publicado y sientes que el análisis SEO manual es un cuello de botella, este tipo de sistema es una inversión de tiempo que se amortiza rápido. No necesitas la misma infraestructura que yo he montado, la lógica conceptual es replicable con herramientas mucho más accesibles.
Lo que importa es cerrar el ciclo: datos de búsqueda → identificación de oportunidades → publicación → seguimiento de resultados. Si ese ciclo está roto o es lento, el contenido que produces es menos eficiente de lo que podría ser.